散列表
散列表/哈希表(hash table)
概念
哈希表(hash table),又称散列表,是根据关键字进行访问的数据结构。哈希表建立了一种关键字和存储地址之间的映射关系,使得每个关键字与结构唯一存储位置相对应
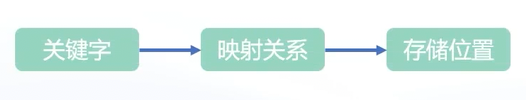
在理想情况下,在散列表中进行查找的时间复杂度为 \(O(1)\),即与表中的元素数量无关
哈希表的思想
案例:统计字符串”abcabcdd”(只包含小写字母)中,每一个字符出现的次数
int cnt[26];
void slove(const std::string& s) {
    for (auto ch: s) {
        ++cnt[ch - 'a'];
    }
}
这个案例就蕴藏着哈希表的思想,若我们想知道字符有没有出现过,则可以把int改为bool类型
数组通过下标访问(
[]、at()),就蕴藏了哈希表中,映射关系的思想哈希函数
将关键字映射成对应的地址的函数就是哈希函数,也叫作散列函数。记作:
hash(key) = addr在上面的案例中,
hash(key) = key - 'a'。交给哈希函数一个关键字,哈希函数给我们计算出一个存储位置哈希函数可能会把两个或两个以上不同的关键字,映射到同一位置上,这种情况被称为哈希冲突,也称散列冲突。起冲突的两个不同关键字被称为同义词
常见的哈希函数
直接定址法
直接取关键字的某个线性函数值为散列地址,即:
hash(key) = a key + b其中a、b为常数,这种计算方式简单,适合关键字基本连续分布的情况;若关键字不连续分布,则会造成存储空间的浪费
除留余数法
假设哈希表的大小为M,那么通过key除以M的余数作为映射位置的下标,就是除留余数法,即:
hash(key) = key % M这种方法的重点就是选好模数M。建议取不太接近2整数次幂的一个质数(素数),具体原理在算法导论中讲解,这样可以减少哈希冲突
其他方法
- 乘法散列法
- 全域散列法
- 在《[数据结构(C语言版)].严蔚敏_吴伟民》等教材中,还给出平方取中法、折叠法、随机数法、数学分析法等,这些方法适用于一些局限的特定场景
处理哈希冲突
线性探测法
从发生冲突的位置开始,依次线性向后探测,直到寻找到下一个没有存储的位置为止,如果走到哈希表尾,则回到哈希表头的位置
案例
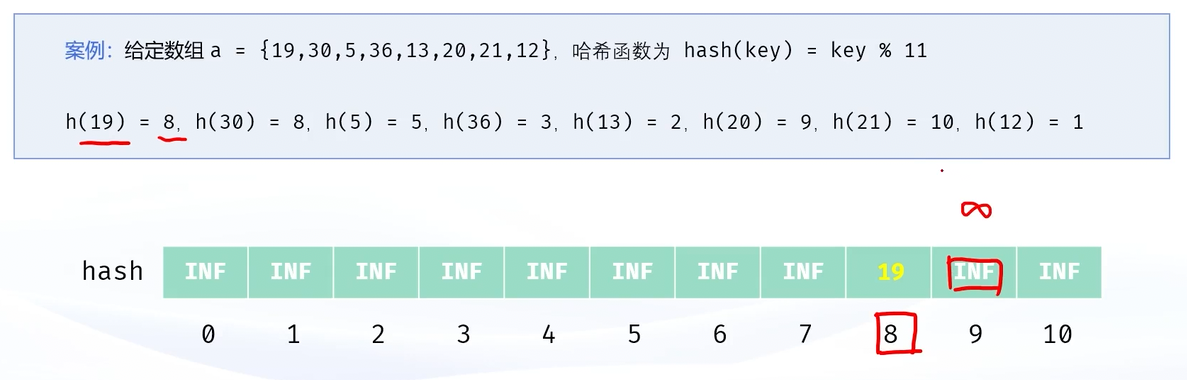
注:初始hash数组为无穷大(INF)的目的,是为了避免出现在给定数组中出现的值
h(30) = 8冲突后,向后找到一个没有存储的位置: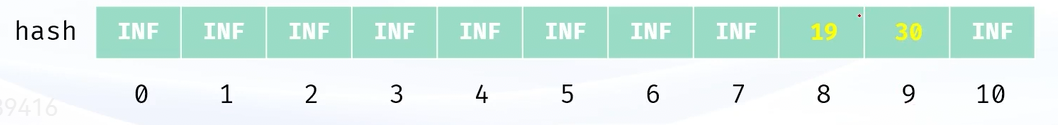
注:若存储的数很密集的话,要处理的哈希冲突比较多,此时线性探测的效率不高,故选择模数时,会选择 原数据个数 x 2 附近的一个质数
链地址法
链地址法的所有数据不再直接存储在哈希表中,哈希表中存储一个指针。没有数据映射这个位置时,这个指针为空,有多个数据映射到这个位置时我们把这些冲突的数据链接成一个链表,挂在哈希表这个位置下面
案例
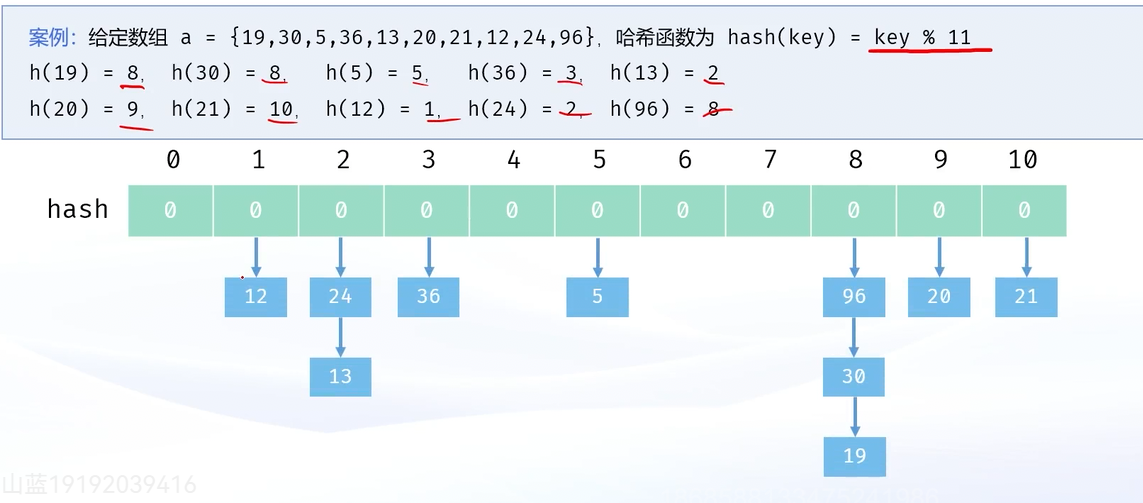
注:
- 链表执行的是头插操作
- 当冲突比较多时,可能全部挂在一个位置,此时时间复杂度为 \(O(N)\)
- 解决冲突多的方法,可以把链表改为红黑树(RBT)
模拟实现哈希表
输入描述:
- 第一行一个整数n,表示查询次数
- 之后n行,为两个整数op、x,分别表示第op个操作,以及元素x(op == 1,把x插入数据结构中,op == 2,查询x是否在数据结构中)
线性探测法实现
#include <iostream>

using namespace std;

class HashTable {
private:
    int* hashTable;
    int INF = 0x3f3f3f3f;
    int sz = 23;

    // 哈希函数
    int f(const int& x) {
        return (x % sz + sz) % sz;
    }

    int getIndex(const int& x) {
        int id = f(x);

        // 处理哈希冲突 - 线性探测法
        while (hashTable[id] != INF && hashTable[id] != x) {
            ++id;
            // 处理走到尾部情况
            if (id == sz) {
                id = 0;
            }
        }
        return id;
    }

public:
    HashTable() {
        hashTable = new int[sz];
        memset(hashTable, 0x3f, sizeof(int) * sz);
    }

    ~HashTable() {
        delete[] hashTable;
    }

    void insert(const int& data) {
        int index = getIndex(data);
        hashTable[index] = data;
    }

    // 查找元素是否存在
    bool find(const int& data) {
        int id = getIndex(data);
        return hashTable[id] == data;
    }
};

int main() {
    HashTable htable;
    int n;
    cin >> n;
    while (n--) {
        int op, x;
        cin >> op >> x;
        if (op == 1)
            htable.insert(x);
        else {
            if (htable.find(x))
                cout << "yes" << endl;
            else
                cout << "no" << endl;
        }
    }

    return 0;
}
链地址法实现
#include <iostream>

using namespace std;

const int N = 23;
int h[N], e[N], ne[N], id;

// 哈希函数
int f(int x) {
    return (x % N + N) % N;
}

// 插入元素并处理哈希冲突
void insert(int x) {
    int idx = f(x);

    // 把 x 头插到 idx 所在的链表当中
    e[++id] = x;
    ne[id] = h[idx];
    h[idx] = id;
}

// 查找元素是否存在
bool find(int x) {
    int idx = f(x);

    for (int i = h[idx]; i; ne[i])
        if (e[i] == x)
            return true;
    return false;
}

int main() {
    int n;
    cin >> n;
    while (n--) {
        int op, x;
        cin >> op >> x;
        if (op == 1)
            insert(x);
        else {
            if (find(x))
                cout << "yes" << endl;
            else
                cout << "no" << endl;
        }
    }

    return 0;
}
unordered_set、unordered_map
注:具体使用参阅C++与STL
unordered_map存图
#include <iostream>
#include <unordered_map>
#include <vector>

using namespace std;

int main() {
    unordered_map<int, vector<int>> edges;
    int n;
    cin >> n;
    while (n--) {
        // 存图,时间复杂度为O(1)
        int a, b;
        cin >> a >> b;
        edges[a].push_back(b);
        edges[b].push_back(a);
    }

    return 0;
}
重复插入元素时,map的反应
#include <iostream>
#include <unordered_map>

using namespace std;

int main() {
    unordered_map<string, int> mp;

    mp.insert({"zhang", 123});
    cout << mp["zhang"] << endl;

    mp.insert({"zhang", 456});
    cout << mp["zhang"] << endl;

    return 0;
}
注:只输出第一个存储的 123